分析 Threads 公開對話時,該以貼文、留言串還是帳號為單位?
依研究問題選擇貼文、留言串或帳號作為分析單位,並用清楚的範圍定義、去重規則與紀錄欄位,避免把不同層次的資料混在一起。
同一批 Threads 公開內容,換一個分析單位,答案就可能不同:逐篇計算會看見貼文內容的分布,串級分析會保留回應關係,帳號級分析則回答哪些帳號在觀察範圍內呈現某種模式。開始收集前,先把問題中的「一筆」說清楚,才不會把貼文數、對話數和帳號數混成同一個比例。
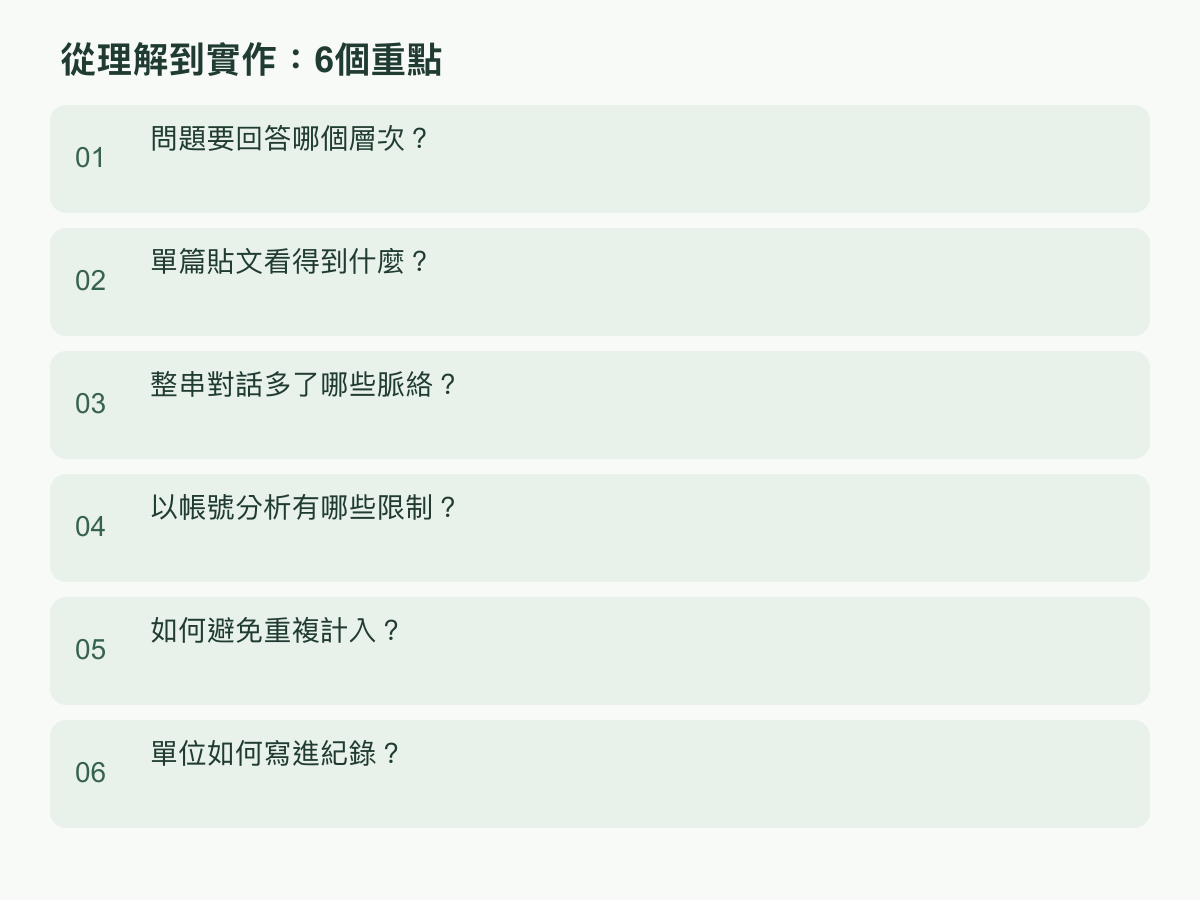
問題要回答哪個層次?
選擇單位的起點,是先確認研究結論會描述什麼。若問題是「這些公開貼文使用了哪些主張或表達方式」,單篇貼文通常是合適單位;若問題是「參與者如何回應、補充或質疑彼此」,就要把留言之間的關係保留下來,以整串對話為主要單位;若問題是「特定帳號在一段觀察範圍內如何發文或參與」,分析重點則是帳號以及它包含的貼文與對話。
這三種單位不能只靠資料長相決定。搜尋結果常以貼文呈現,但研究問題可能關心一段完整互動;資料頁面顯示帳號名稱,也不代表每一列都應算成一個帳號。先把問題改寫成可觀察的句子,再定義單位。例如,把「大家怎麼看某主題」改成「納入範圍的公開貼文中,有多少篇表達支持、反對或提出疑問」。這個問法指向貼文,不足以直接代表所有使用者的看法。
還要區分分析單位、抽樣單位和記錄單位。抽樣單位是你用來挑選資料的對象,分析單位是最後推論的對象,記錄單位則是表格中一列代表的內容;三者可以相同,也可以不同。研究者可能先抽取帳號,再分析每個帳號的貼文,最後以貼文為一列記錄。這種設計必須保留帳號識別欄位,否則後續無法判斷資料是否集中在少數帳號。
實際操作時,先寫一句單位規則,再拿幾筆候選資料試套。如果同一則內容能被你算成一篇貼文、一串對話或一個帳號,卻沒有明確理由,就表示問題與單位還未對齊。只有當你能說出每一筆的納入範圍、排除情況,以及最後要比較的分母,才開始正式收集。這一步可以避免分析完成後才發現,表格回答的是另一個層次的問題。
單篇貼文看得到什麼?
以單篇貼文為單位,適合描述一則公開內容本身可觀察到的特徵,例如文字主題、用詞、立場線索、媒體形式,或貼文是否提出問題。每列代表一則貼文,可以按事先定義的類別標註,再計算各類別的篇數或比例。這種設計容易比較不同貼文,也較容易檢查同一篇是否被重複收錄。
先寫清楚一篇貼文的邊界:引用內容、附加媒體、標籤或貼文中的連結,是否屬於要編碼的材料?若只分析文字,就不要在部分樣本中把圖片說明一起算入;若媒體內容是研究重點,就應說明它如何被讀取和分類。接著訂定納入規則,例如內容必須包含哪些主題詞、位於哪段觀察範圍,以及重複出現的貼文如何處理。規則不必複雜,但每一筆都要能用同一套標準判斷。
貼文單位也適合做清楚的編碼表。可以為主題、表達功能或立場設欄位,每個欄位先定義可選答案,並放入邊界例子說明「符合」與「不符合」的差異。遇到一篇貼文同時談到多個主題時,須事先選擇單一主題、允許多重標註,或另設主要與次要主題;不同做法會改變統計分母,不能分析結束後再挑較好看的算法。
它的限制是會把回應脈絡切開。單看一則回覆,可能無法知道它是在同意、反諷、補充,還是回答前一則提問;單看主貼,也可能看不到留言如何改變對話方向。因此,貼文內容中的觀點只能支持對該貼文的描述,不能直接當成整串對話的共識或作者穩定立場。若需要使用回應關係,至少要另存貼文與父貼文的連結,或改用留言串作為分析單位。
例如,研究「公開內容如何提出問題」時,可以將每篇貼文標成開放式提問、封閉式提問或沒有提問,並檢查各類別的判定是否一致;若研究要回答的是「提問後參與者如何接續討論」,則只編主貼會漏掉關鍵材料。選貼文單位的判準,是結論主要描述單篇內容,而不是讀者反應、對話走向或整個帳號的行為。
整串對話多了哪些脈絡?
以整串對話為單位,可以把主貼與符合規則的回覆放在同一個分析範圍中,觀察話題如何延伸、不同參與者如何接話,或原本的提問是否獲得回應。這時每串對話是一個分析個案,串內的每一則貼文仍可作為次級觀察記錄。保留主貼、回覆與父子關係,可以讓研究者知道某句話在對話中的位置,而不只讀到孤立文字。
開始前要定義一串對話的邊界。可以把某則主貼及其可取得的回覆視為一串,也可以只納入指定層級或時間範圍內的回覆。若回覆又引出下層對話,要明確說明是否納入;若某則內容只是提到另一篇貼文,卻沒有可確認的回覆關係,不應只因主題相似就併進同一串。邊界規則要在收集前固定,否則不同個案可能一個含完整回覆、一個只含主貼,最後比較便失去一致性。
可按以下順序整理:先記錄主貼識別資訊,再收集符合邊界規則的回覆,接著為每則內容保存父貼文識別資訊,最後將串內互動整理成研究需要的類別。若要比較對話是否出現提問、反駁或補充,先定義每種互動的判定方式,再標記發生位置。每串可以得到一個整體判斷,也可以逐則編碼後再匯總,但必須標明哪個欄位屬於貼文層級、哪個欄位屬於整串層級。
這樣的設計能呈現互動脈絡,卻不等於一定取得完整對話。公開頁面或搜尋結果所能看到的內容可能不完整,部分回覆也可能無法納入你的資料。因此,應記錄實際採用的抓取邊界和可取得範圍,不要把「收集到的回覆」寫成「所有參與者的完整反應」。分析結論要限於符合規則且實際觀察到的對話材料。
舉例來說,若研究問題是「一個提問串中,回覆主要是在提供經驗、提出疑問,還是轉換話題」,整串是主要分析單位;回覆是串內編碼單位。可以先為每串判斷是否有經驗分享,再逐則標記互動類型。若同一串收錄了多則相同類型回覆,報告中需說清楚比例是以回覆數為分母,還是以對話串數為分母。前者回答回覆分布,後者回答有多少串出現此現象,不能互換。
以帳號分析有哪些限制?
帳號作為分析單位,適合回答「在這份樣本中,哪些帳號呈現某種發文或參與模式」。實際做法通常要先定義帳號納入條件與觀察範圍,再收集每個帳號符合條件的貼文或對話,最後在帳號層級彙整。這時一個帳號可能包含多篇貼文和多串對話;若直接把所有貼文混在一起計算,就會讓發文較多的帳號占較大比重,結論也不再是帳號之間的比較。
可先明確說明帳號如何進入樣本:是由主題搜尋結果中出現的帳號組成,還是依照其他可重現的條件挑選?帳號被納入後,計算全部可見內容、符合關鍵詞的內容,還是限定在某個時間區間?同時要記下每個帳號實際收錄幾篇貼文,否則無法分辨某種模式是多數帳號都出現,還是由少數高頻發文帳號拉高。
帳號層級資料不能直接揭示帳號背後的個人身分、動機或長期信念。帳號名稱或簡介提供的是可見資訊,不足以證明帳號由某種特定身分的人經營;某一段時間內的公開發文,也不能代表帳號在其他時段的表現。可將觀察到的行為寫成「樣本中此帳號的貼文多次出現某類內容」,不要跳成「此人一向如此」或「某群人都如此」。
另一個限制是選樣偏差。若帳號是從某個關鍵詞的搜尋結果中找到,樣本自然偏向在可見內容中使用該詞的帳號;沒有出現在結果裡的帳號不一定不存在,也不一定沒有談過相同主題。比較不同帳號時,應說明樣本來源和納入規則,避免把觀察到的帳號集合描述成整個平台的代表。若問題本身只關心這批帳號,直接界定結論適用的範圍即可。
帳號單位適合做個案摘要或帳號間比較,不適合不加區分地混算不同層次的數字。報告中可並列帳號數、貼文數和對話串數,並指出每個結論所使用的分母。若要呈現帳號層級的模式,先為每個帳號計算相同指標,再比較帳號;若要呈現所有貼文的整體分布,則按貼文計算並清楚標示。兩種結果都可能有用,但回答的是不同問題。
如何避免重複計入?
Threads 公開內容可能因不同搜尋條件、不同入口或展開留言串而重複出現在工作表中。去重前先決定你要數的是貼文、對話串還是帳號,再為各層級保留可比對的識別資訊。相同貼文被兩種搜尋方式找到,通常應視為一則貼文並保留兩個來源紀錄;同一個帳號發了多篇貼文,則不是貼文重複,而是多筆貼文屬於同一帳號。
優先使用可穩定比對的貼文識別資訊或貼文網址,並另存對話串識別資訊與帳號識別資訊。若無法取得穩定識別碼,才使用事先說明的替代比對規則,例如網址、作者欄位與文字特徵的組合;這類規則有可能把相似但不同的內容誤合併,應把無法確定的項目保留人工檢查標記。不要只依文字相似度自動刪除,因為轉述、引用或重複發布的內容可能很像,但在研究中仍是不同貼文。
以下是純假設的貼文去重計算:
| 收集來源 | 來源內不重複貼文數 | 與另一來源重複的貼文數 |
|---|---|---|
| 關鍵詞搜尋結果 | 5 | 2 |
| 對話展開結果 | 4 | 2 |
| 合併後不重複貼文 | 7 | — |
合併後貼文數的算式是 5 + 4 − 2 = 7;重複的兩篇各自只計一次。這個結果只表示合併後的貼文筆數,不代表有七串對話或七個帳號。若要數對話串,應再對串識別資訊去重;若要數帳號,則對帳號識別資訊去重。保留來源欄位可以追查每筆資料從哪裡進入,也能在比對規則更新時重做合併,而不必丟失原始收集紀錄。
正式計算前,至少檢查三件事:同一識別碼是否有多列、同一貼文是否因不同網址形式被視為兩筆,以及不同貼文是否被錯誤合併。接著把去重前筆數、去重後筆數和採用的規則寫入紀錄。若分析單位是對話串,串內的貼文本來就可能有多則,不應把它們當成重複串刪掉;如果一則貼文出現在兩種資料來源,才是跨來源重複。分清這兩種情況,才能讓每個數字對應到正確的單位。
單位如何寫進紀錄?
把單位寫進紀錄,不只是填一個「貼文/留言串/帳號」欄位,而是要讓另一位整理者看得出這一列代表什麼、邊界在哪裡、如何計數。建議為每筆資料設一個分析紀錄編號,再保存主要單位、納入規則、關聯識別資訊、觀察範圍、編碼欄位與資料來源。若一列代表整串,仍可在附屬表中一列一則記錄串內貼文,並用串識別資訊連結兩張表;不要把多則回覆塞在同一格,讓後續無法重算或比對。
可以使用這份精簡欄位範本:
| 欄位 | 要記錄的內容 |
|---|---|
| 分析紀錄編號 | 此列的唯一編號 |
| 主要分析單位 | 貼文、留言串或帳號 |
| 單位識別資訊 | 貼文、串或帳號的比對欄位 |
| 納入與排除規則 | 哪些內容屬於此列,哪些不納入 |
| 關聯識別資訊 | 父貼文、對話串或帳號的連結 |
| 收集與來源紀錄 | 取得位置、收集時間及去重狀態 |
| 編碼與分母 | 標註結果,以及計算所用的單位數 |
填寫時,先給出一個具體例子:例如某列代表一串以主貼為起點、只納入符合預定回覆邊界的對話;主貼識別資訊放在主要欄位,每則回覆的識別資訊放在串內明細,並保留來源與去重狀態。另一列若代表帳號,就應保存該帳號納入了哪些貼文或對話,以及彙整指標如何得出。這樣遇到總數不一致時,可以回到識別欄位查找,而不是憑記憶猜測是哪筆被多算。
若你的前置工作是尋找相關 Threads 公開貼文或關鍵字,ThreadScout 可協助探索相關內容、整理每日佇列並產生三則回覆草稿;使用者編輯、選擇後手動發布。這些功能處理內容探索與回覆草擬,不會代替你決定研究單位、保存完整研究資料,也不保證自動回覆或自動留言。研究設計仍要由你明確寫下每一列代表什麼,以及數字的分母是貼文、留言串還是帳號。下一步,先把你的研究問題改寫成一句可判斷的句子,替一筆候選資料填好單位與邊界,再從 ThreadScout 開始探索相關內容。