Threads 關鍵字遇到同詞異義,怎麼排除無關貼文?
用需求定義、語境詞、貼文抽樣與誤搜比例比較,找出同一個 Threads 關鍵字指向不同事物時的排除方法,並把判斷依據留存下來。
搜尋 Threads 關鍵字時,最容易讓判斷失準的情況之一,是同一個詞在不同貼文裡代表不同需求。字面相同,不表示談的是同一件事;如果只看命中數量,熱門但無關的語境也可能混進結果。這篇聚焦在同詞異義的誤搜校準:先定義需求,再整理詞義、補上語境、抽樣判讀,最後留下可重複使用的排除依據。
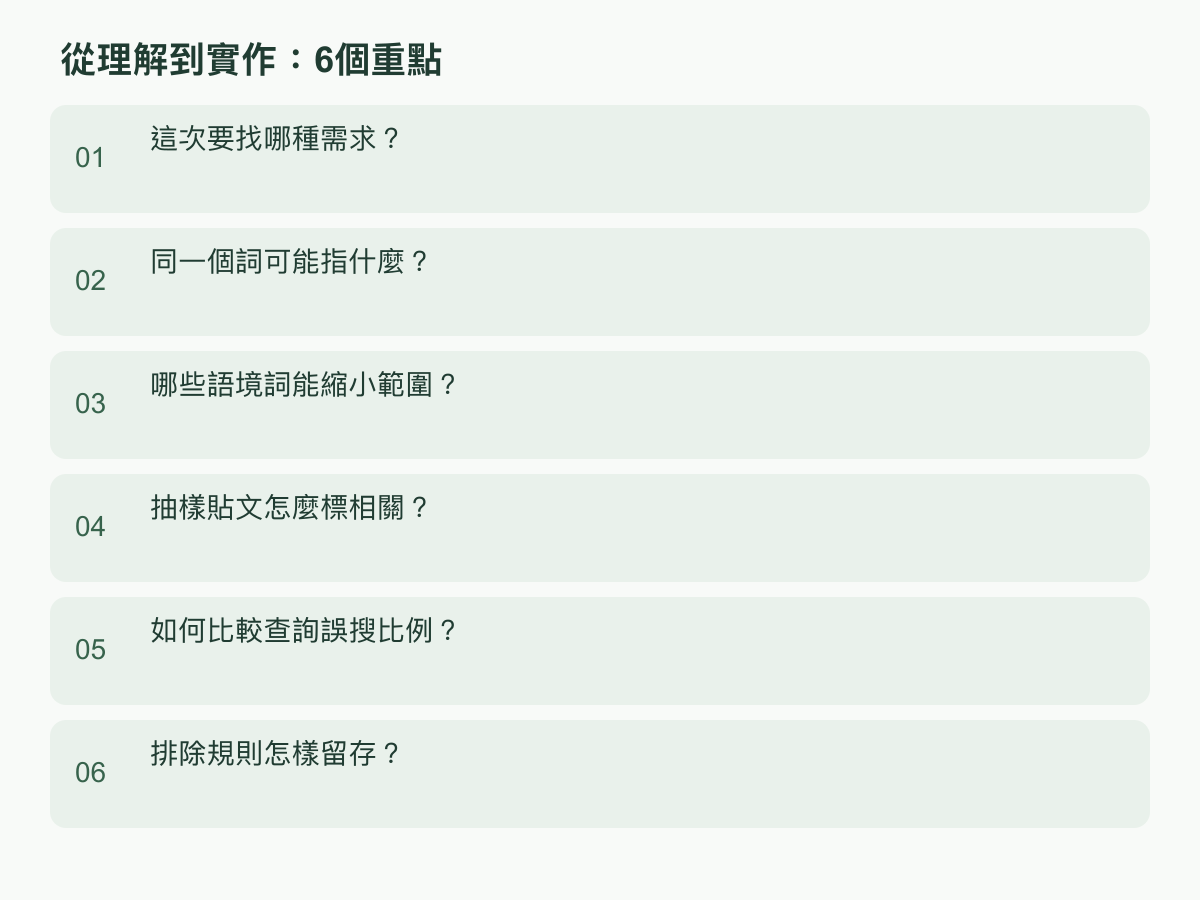
這次要找哪種需求?
先用一句話寫下這次搜尋要回答的問題。不要只寫「找某個關鍵字的貼文」,要補上你想理解的主題和讀者正在做的事。例如,你想觀察小型店家如何談社群內容安排,還是想找討論某個同名工具的貼文?這兩種需求可能共用詞語,卻不能用同一套相關標準。
接著決定什麼樣的貼文能幫上忙。可以把範圍拆成三個條件:貼文在談的對象、作者正在處理的情境,以及貼文能提供的資訊。若研究的是店家經營,提到店家、客人或內容安排的貼文可能直接相關;只在暱稱、玩笑或其他主題裡出現同一個詞,通常不能回答這個問題。
還要先選定觀察單位:你要評估一則貼文是否相關,還是要看一個查詢能不能找到足夠的相關討論?前者適合拿來標記單篇內容;後者還需要比較不同查詢的結果。兩者分開記錄,避免看到一則好貼文就判定整個查詢有效,也避免因為幾則無關貼文便直接放棄有用的詞。
例如,假設需求是理解店家如何回覆顧客留言,那麼談顧客互動、回覆方式或工作流程的貼文可以納入。若貼文只是出現相同字詞,實際談的是影視劇情或個人日常,就算文字完全吻合也不算符合需求。先寫好這條界線,後面才有一致的判斷基準。
同一個詞可能指什麼?
先把詞語可能代表的意思列出來,暫時不要急著判斷哪一種才是正解。可以從使用者、領域、動作與場景來拆解:誰在使用這個詞?它指的是人物、品牌、功能還是一般概念?貼文是在詢問、推薦、抱怨,還是敘述生活?同一個詞在不同領域裡,可能各有一套自然的搭配詞。
再用實際看到的貼文補充候選詞義。每種意思寫一個簡短描述,旁邊記下支持線索和可能的反例。例如,某詞可能指一種社群操作方式,也可能是商品名稱;若貼文附近常出現「內容」、「互動」等字眼,較像前者,若搭配型號、購買或使用心得,則可能屬於商品語境。這些只是判斷線索,不能只靠一個詞就定案。
有些結果會同時帶有多種線索,或完全看不出詞義。先把它標成待判,不要硬塞進最常見的類別。尤其是短貼文、引用片段或只有一句話的內容,缺少主詞與上下文很常見。此時可以記錄為資訊不足,之後再看是否能由貼文其他文字判讀;無法判讀就不納入相關比例的分子。
完成初步整理後,挑出最容易混淆的兩種意思,寫下區分它們的可觀察條件。條件必須能從貼文內容辨認,例如是否談到特定對象、是否描述明確行動,而不是猜作者的背景或意圖。如此一來,不同人重看同一筆結果時,會有機會依據相同線索做出相近判斷。
哪些語境詞能縮小範圍?
語境詞的作用,是讓查詢更接近你定義的需求。優先挑能代表對象、動作或場合的詞,而不是再加入一串相近的大詞。例如,想看店家如何處理顧客互動,可以把「店家」、「顧客」、「回覆」當成候選語境詞;如果只加「社群」、「行銷」等寬泛詞,結果仍可能落在很多不同方向。
把候選詞分成幾組,每次只調整一個條件。第一組保留原詞,第二組加上需求對象,第三組再加上具體動作。實際搜尋時,依平台當下可用的方式逐組查詢;不要預設所有搜尋介面都支援相同的運算符或語法。若介面無法組合條件,就分開搜尋並在紀錄中註明每組使用的完整字詞。
選語境詞時,也要想想它會不會把真正相關的貼文排除掉。過度精確的詞可能只有少量結果,因為作者用的是口語、縮寫或另一種說法。可以替每個重要概念準備一兩個同義表達,再逐一抽樣比較;但不要把所有變體混成一個查詢,否則看不出究竟是哪個詞改善了結果。
例如,原詞可能同時指一般操作概念和一個同名商品。若加上「店家回覆」後,結果多談工作情境,便值得檢查它是否降低了誤搜;若加上某個過於狹窄的職稱後,結果雖然很乾淨卻幾乎沒有貼文,則未必是更好的查詢。判斷時要一起看相關程度和可用內容,而非只追求最少的無關結果。
抽樣貼文怎麼標相關?
先選定一批結果,再用同一套標準逐則判讀。若結果很多,可固定抽取前段的一部分,並記錄抽樣範圍或位置,讓之後比較時知道資料從哪裡來。若要比較兩個查詢,就盡量採用相同的抽樣數、相近的觀察時點和相同的納入規則。不要一個查詢看最新結果,另一個查詢挑最像需求的貼文來比。
標記時可用三類:相關、不相關、資訊不足。相關表示貼文主題能直接回答本次需求;不相關表示只是詞面相同或落在其他意思;資訊不足表示現有內容無法判斷。再加一欄簡短理由,例如「談顧客回覆流程」或「同名商品心得」,讓標記能被重看。這比只留一個勾選更有用,因為之後可以檢查判斷是否一致。
以下是為了說明標法而設計的假設例句,並非實際貼文。若需求是觀察店家如何回覆顧客留言,「我會先整理常見問題,再回覆每位客人」可標為相關;「剛買了同名商品,使用感想如下」可標為不相關;「今天看到這個詞,想到以前的事」若沒有更多上下文,可標為資訊不足。判斷依據是內容是否符合需求,不是語氣正面或負面。
遇到邊界案例時,把有爭議的線索記下來,再用既有定義重看一次。若團隊成員能互相檢查,可以先各自標記一小批,再對照哪些貼文分類不同,將差異歸因到需求定義不清、詞義重疊或上下文不足。修正標準後,重看受影響的貼文;不要為了讓數字好看而把難判的內容全部算相關。
如何比較查詢誤搜比例?
先決定用什麼比例來比較。對抽到的貼文而言,簡單做法是用「不相關貼文數 ÷ 可判讀貼文數」計算誤搜比例;資訊不足另外報告,不要偷偷併入不相關或相關。比較前也可以列出相關貼文數,因為某個查詢即使誤搜比例較低,若幾乎找不到可用內容,也不一定符合任務。
以下數字都是假設例子。假設兩個查詢各抽樣二十則貼文,第一組有十二則不相關、六則相關、兩則資訊不足,誤搜比例是十二除以十八,約百分之六十七;第二組有五則不相關、十三則相關、兩則資訊不足,誤搜比例是五除以十八,約百分之二十八。第二組在這批樣本中更貼近需求,但仍應保留抽樣數和資訊不足數,不能把結果說成整個平台上的精確比例。
| 假設查詢 | 不相關 | 相關 | 資訊不足 | 誤搜比例計算 | 判讀 |
|---|---|---|---|---|---|
| 原詞 | 12 | 6 | 2 | 12 ÷ (12+6) = 約 67% | 誤搜較多,檢查詞義混淆 |
| 加入需求語境 | 5 | 13 | 2 | 5 ÷ (5+13) = 約 28% | 這批樣本較符合需求 |
計算時分母排除資訊不足,是為了避免把無法判讀的貼文誤當成已確認的不相關內容。也可以同步記下「資訊不足數 ÷ 抽樣總數」,看查詢是否常帶回缺少上下文的結果。兩個指標要一起讀:若某組誤搜比例低,但資訊不足很多,結論仍不穩;可以補抽樣本或調整語境詞後再比較。
這些比例描述的是你抽到的結果,不是平台整體內容,也不是固定成效承諾。若樣本很小、結果排序不同,或兩組查詢的觀察條件不一致,差距可能來自抽樣方式。比較完應回答的是「在這次相同條件下,哪個查詢帶來較多可判讀且符合需求的貼文」,而不是宣稱某個詞永遠更準。
排除規則怎樣留存?
把每次判斷整理成可重做的紀錄:本次需求、原始詞、候選詞義、使用的語境詞、抽樣範圍、標記結果、計算方式,以及排除理由。每條排除規則都要寫成可觀察的條件,例如「只有同名商品心得,未談店家互動者不納入」,而不是只寫「排除奇怪貼文」。前者能讓其他人照著判斷,後者則需要重新猜測你的意思。
同時保留例外和反例。若某個語境詞大多帶來相關內容,但偶爾也引出另一種詞義,就記錄這種混用情況;若某則貼文因上下文不足而排除,也寫明不足之處。規則的目的不是保證每一篇都能自動分類,而是讓後續的人知道目前採用的界線,以及哪些情況仍需人工判斷。
當需求改變、詞語用法出現新意思,或抽樣結果連續出現原本沒預期的誤搜時,再檢查舊規則。修改時留下版本或日期,簡述改了哪個條件,以及重看哪些既有樣本。若規則變動後直接沿用舊比例,可能會把不同標準下的結果混在一起;需要比較時,應用新標準重標相關樣本,或清楚區分前後兩套定義。
現在就挑一個正在造成混淆的詞,寫下一句需求、列出兩種可能意思,再抽一小批貼文試標;看完後記下第一條可觀察的排除規則。想了解 ThreadScout,請前往ThreadScout。